
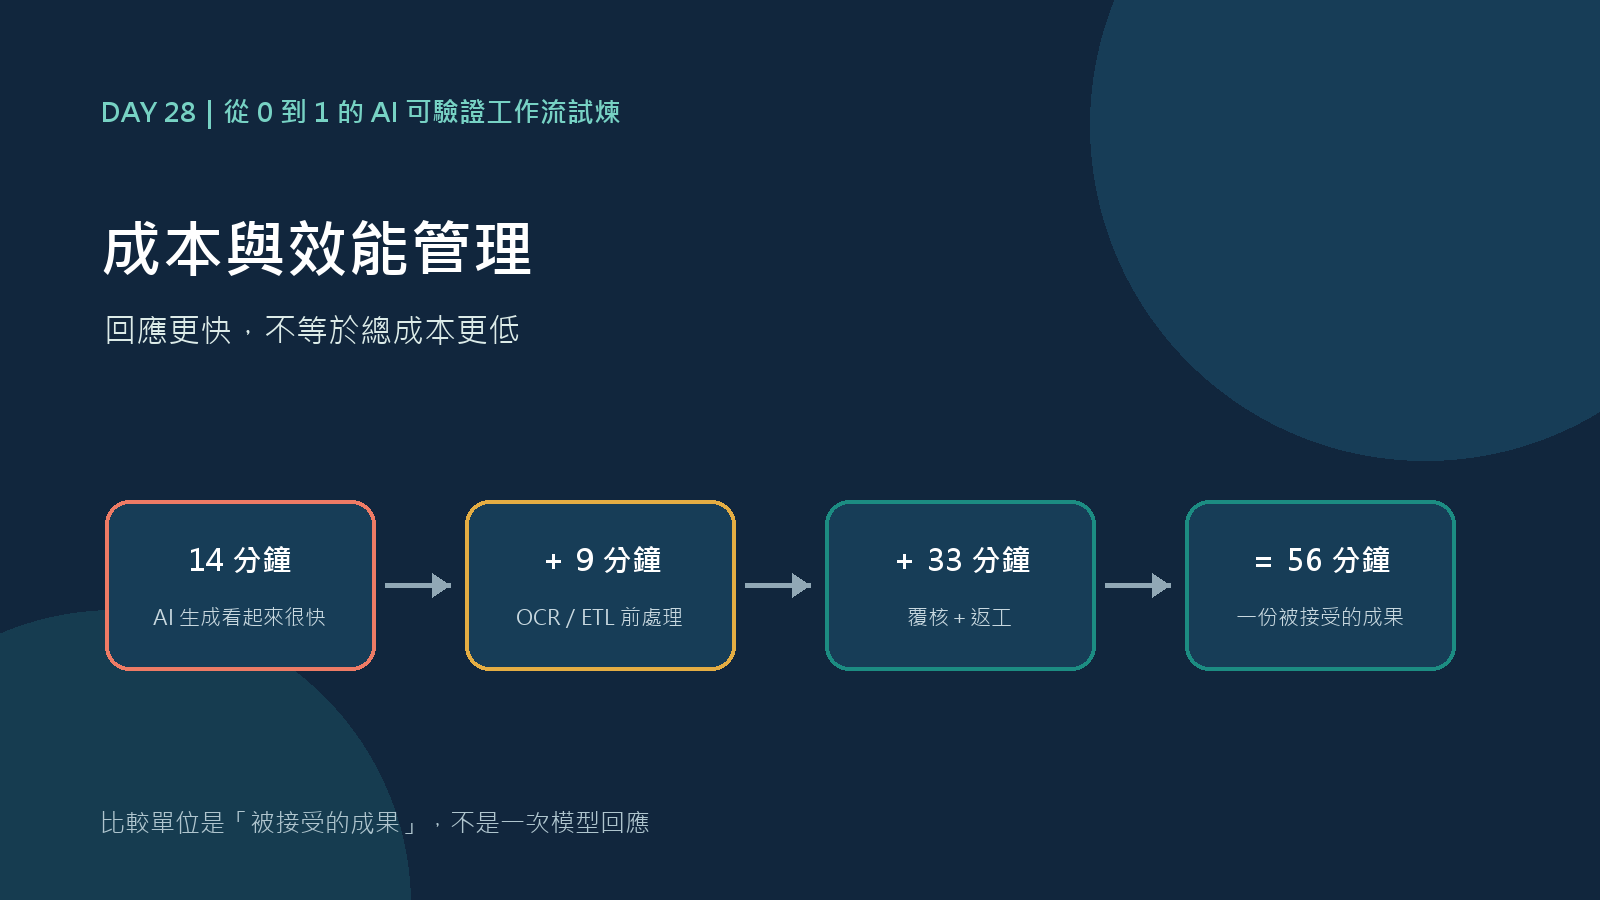
Day 27 那位同事用 Codex 補「OCR/ETL 前處理的單元測試」這件事,後來被我寫進治理盤點表那一列。這次換我自己去追這項任務實際花了多久:上傳測試情境、跟 Codex 對話、覆核測試案例、發現遺漏、要求修正、再覆核。生成那一步確實只花幾分鐘,但從「開始」到「這份測試檔真的能合併進主分支」,中間還有一大段沒被算進去。今天就用這個真實任務,算一次完整的成本。
如果只記錄「Codex 多快吐出第一版測試」,會嚴重高估效率。我改用「一份通過覆核、可以合併的測試檔」當比較單位,把 OCR/ETL 前處理時間、AI 生成與等待時間、我自己的覆核時間、還有因為遺漏而重跑的次數,全部算進去。
| 成本項目 | 本案例數值 |
|---|---|
| 模型/方案使用 | 共 6 輪對話,未量測精確詞元(token)數 |
| OCR/ETL 前處理時間 | 約 9 分鐘(含 2 份低解析度情境重新確認) |
| AI 草稿生成執行與等待時間 | 約 14 分鐘 |
| 複核人員審查時間 | 約 22 分鐘 |
| 重新生成與返工 | 2 次,共 11 分鐘 |
| 最終被接受草稿 | 第 3 版(v3),8 項測試通過覆核 |
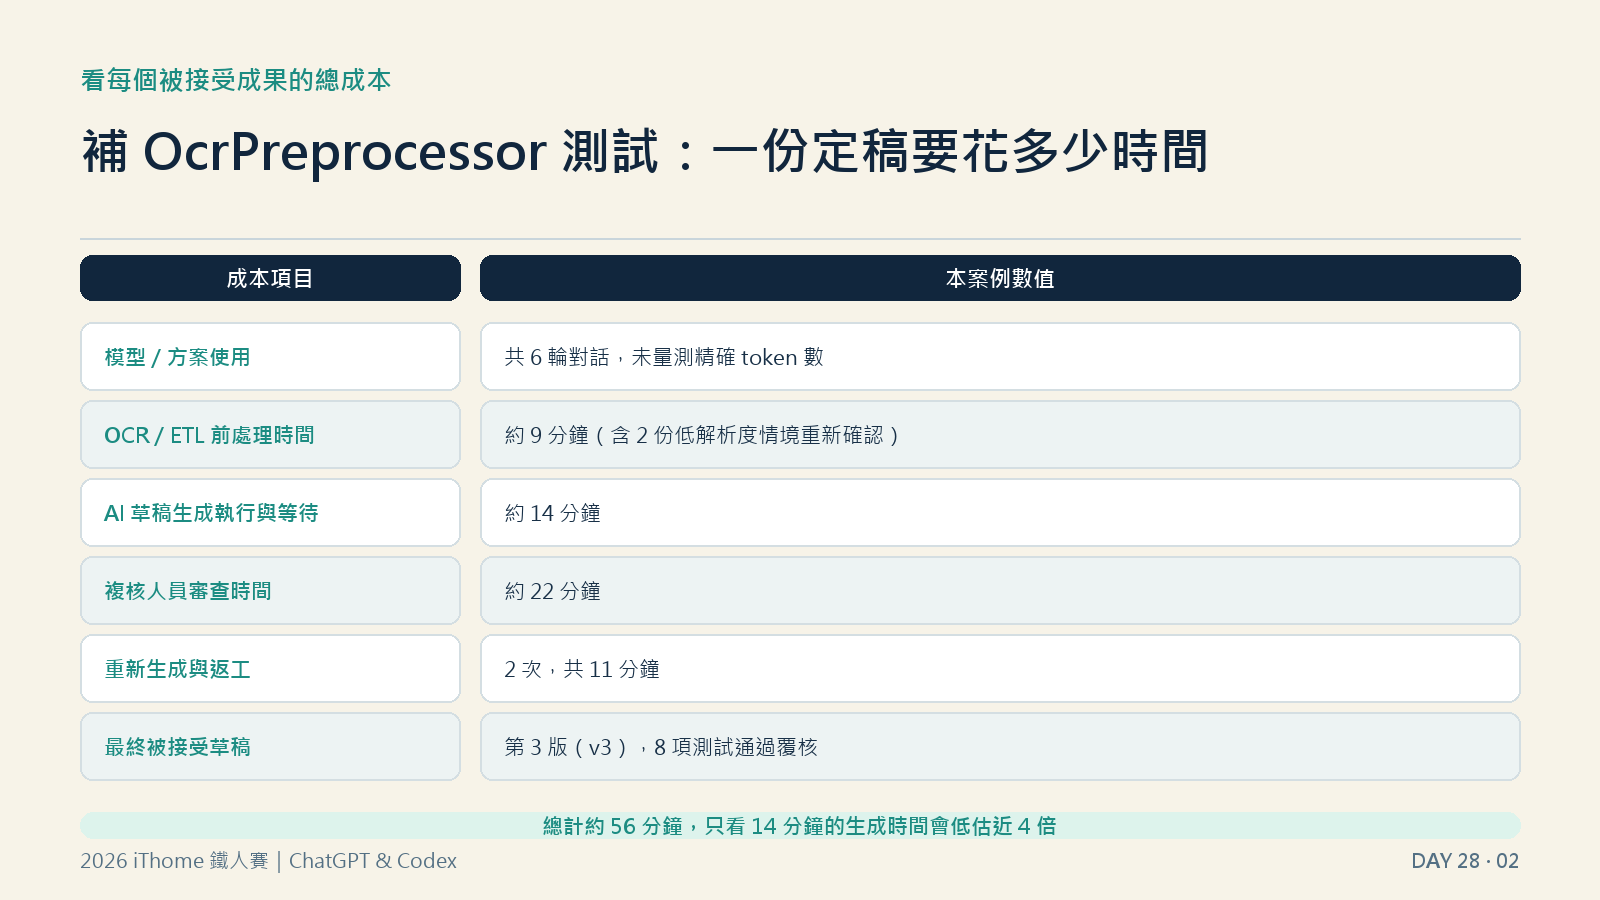
加總下來大約 56 分鐘,只看「AI 生成」那 14 分鐘,等於低估了將近 4 倍。模型方案費用與詞元(token)用量我沒有寫死金額,這部分要在發布當天依當時的訂閱方案或應用程式介面(Application Programming Interface,API)計價重新查證。
同一份測試檔,我實際跑了兩種做法。任務內容是替 OcrPreprocessor 補測試——這個類別依信心分數把掃描檔分成接受、轉人工複核、重試、退回四種結果,對應需求書第七節那題「OCR 辨識準確率的可接受門檻是多少」。
public OcrOutcome evaluate(String extractedText, double confidenceScore, int retryCount) {
    if (extractedText == null || extractedText.isBlank()) {
        return OcrOutcome.REJECT;
    }
    if (confidenceScore >= ACCEPT_THRESHOLD) {
        return OcrOutcome.ACCEPT;
    }
    if (confidenceScore >= MANUAL_REVIEW_THRESHOLD) {
        return OcrOutcome.MANUAL_REVIEW;
    }
    if (retryCount < MAX_RETRY) {
        return OcrOutcome.RETRY;
    }
    return OcrOutcome.REJECT;
}
策略 A:我一口氣請 Codex 生成完整測試檔。策略 B:先請它產生骨架與 3 個基本案例,我覆核一次再往下補。
| 項目 | 策略 A:一次生成 | 策略 B:拆成小步驟 |
|---|---|---|
| 首次產出時間 | 4 分鐘產生 9 個測試案例 | 3 分鐘產生骨架+3 個基本案例 |
| 覆核發現的問題 | 漏掉信心分數剛好等於門檻值(0.90、0.70)的邊界案例,還有 1 項斷言只檢查型別 | 第二步驟覆核時就抓到邊界值遺漏 |
| 重跑次數 | 2 次:整批重生成+單獨修正斷言 | 1 次:只針對邊界案例小幅修正 |
| 總耗時(含覆核與返工) | 約 31 分鐘 | 約 19 分鐘 |
| 最終結果 | 9 個測試,2 項需後補 | 8 個測試,一次涵蓋邊界案例 |
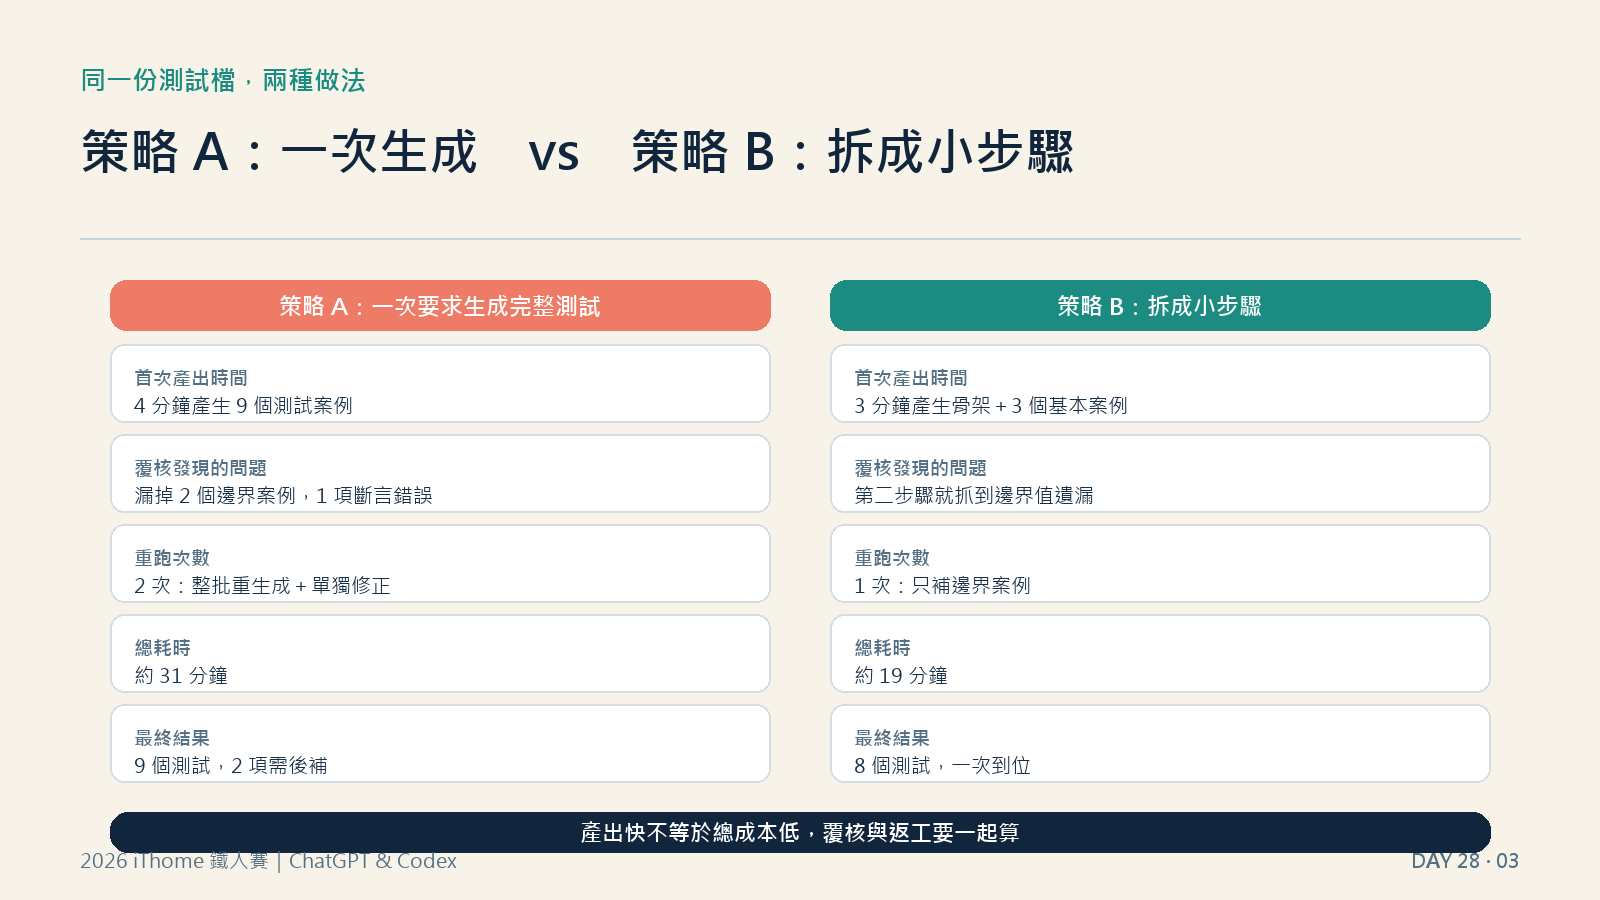
兩種做法最後都收斂到現在 OcrPreprocessorTest 的 8 項測試:策略 A 那 9 個案例裡,1 個斷言只檢查型別、修正後和另一個邊界案例重複,整併掉一個就變成 8 個;策略 B 一開始就設計 8 個,不多不少。任務難度、範圍與驗收標準完全相同,差異只在覆核與返工吃掉的時間。策略 A 產出看似快,總成本卻比較高。
除了「補 OCR 測試」,我手上還有兩件延續 Day 27 情境的工作:複核介面加否決原因欄位、OCR 輸出格式與 AI 生成 prompt 調整。把三個組合攤開比較後才發現,只看有沒有相依關係還不夠,共用資料結構也是風險。
| 任務組合 | 相依性 | 衝突風險 | 建議排程 |
|---|---|---|---|
| 補 OCR 測試 + 複核介面否決原因欄位 | 無 | 低(不同模組、無共用檔案) | 並行 |
| 先定義資料敏感度分級規則 → 再讓 ETL 產生存取權限 | 高(後者依前者結果) | 中 | 串行 |
| OCR 前處理輸出格式調整 + AI 草稿生成 prompt 調整 | 中(共用同一份 OCR 輸出資料結構) | 高(介面若同時改,prompt 假設的欄位會對不上) | 先對齊輸出契約,再各自並行 |
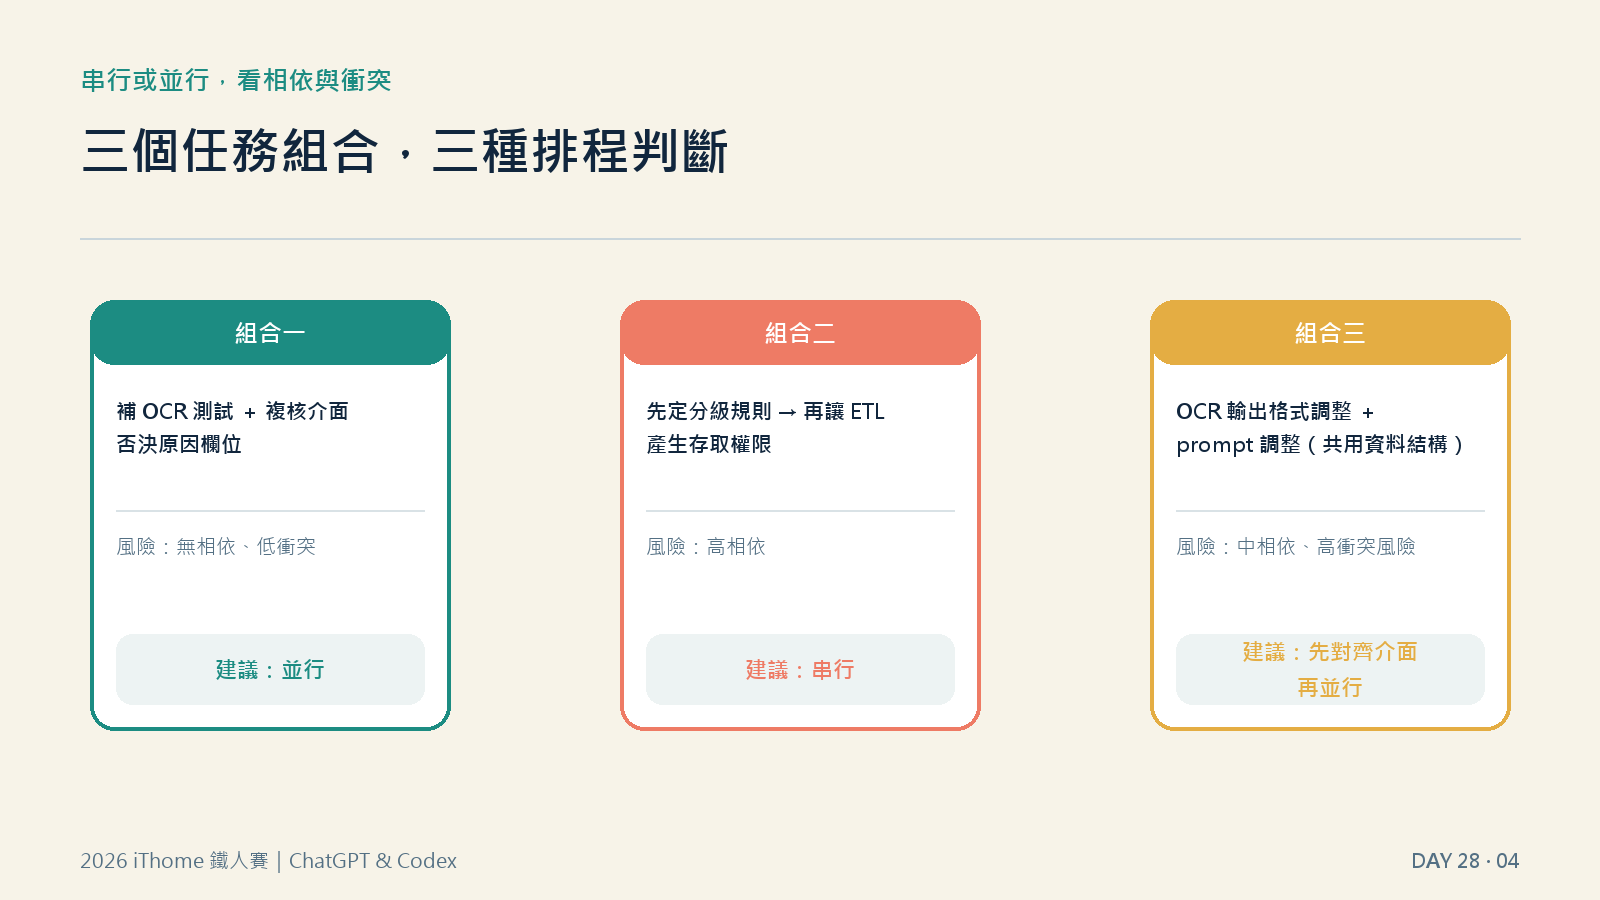
第三組是我這次才想清楚的:OCR 輸出格式跟 prompt 沒有嚴格先後順序,兩人各自開分支也不會踩到同一個檔案,但都依賴同一份資料結構。真的同時動手,很可能一邊先改了欄位名稱,另一邊的 prompt 還假設舊格式,合併時才發現對不起來。我的做法是先花十分鐘對齊輸出契約,確認欄位定義沒問題,才各自並行。
把前處理、生成、覆核、返工都算進去後,我看任務的方式變了:上下文越清楚、範圍切得越小,覆核越快抓到問題,返工自然變少,這才是省下來的真成本,不是模型回應變快。但成本最佳化不能拿來砍測試案例數、跳過複核,或放寬存取權限檢查,那些屬於 Day 27 治理骨架管的範圍。
今天用一個真實任務算了一次總成本:56 分鐘裡,AI 生成只佔 14 分鐘,拆小步驟比一次生成省下約 12 分鐘的返工時間,共用資料結構的任務則要先對齊介面才能並行。這些數字只來自我這一次的操作,樣本數是 1,不能直接當成通用結論。Day 29 會回頭處理需求書第七節留下的另一個問題:系統導入後,要怎麼量測是不是真的縮短了撰寫時間、草稿被大幅修改或否決的比例有多高。


 iThome鐵人賽
 看影片追技術